
宇树发布通用人形机器人模型:7 项具身推理评测领先参评开源模型
-
8小时前
来源:极客公园
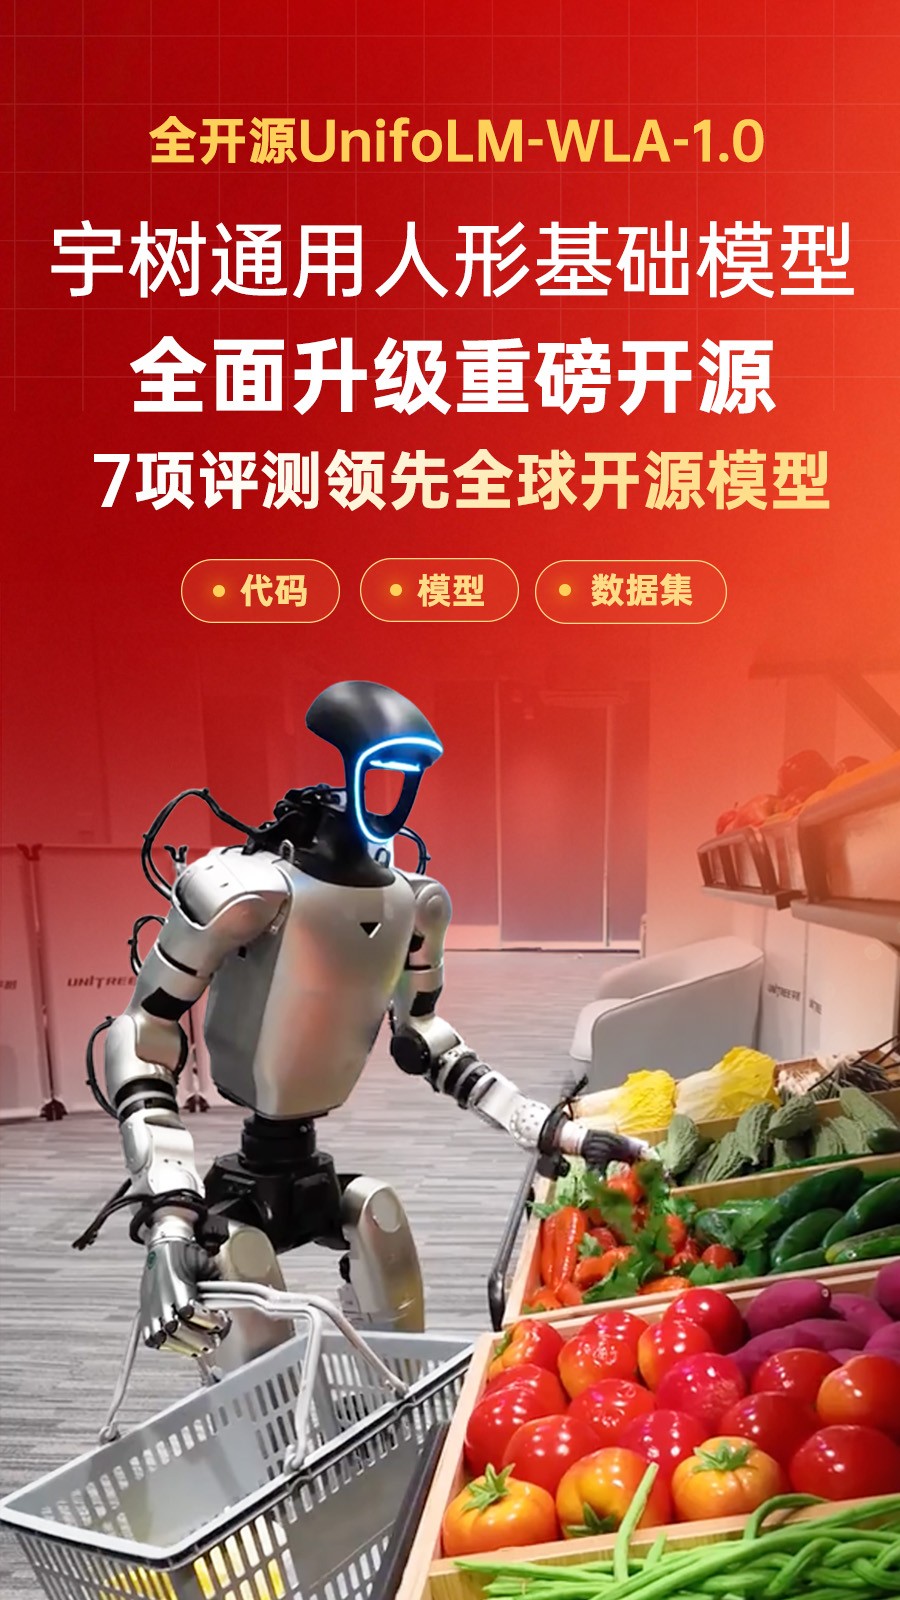
近日,宇树科技发布通用人形机器人基础模型 UnifoLM-WLA-1.0。WLA 是 World-Language-Action,即世界-语言-动作。其具身推理底座 UnifoLM-ER-1-4B 在 16 项多模态感知与理解基准中,有 7 项领先表中参评的开源模型;整体结果与多款闭源模型处于相近水平。项目当前已开放部分模型权重和数据,其他模型、代码与数据仍在后续开放计划中。
这组结果显示,宇树在具身空间感知与推理方面进入开源模型前列。随着模型权重和数据逐步开放,人形机器人行业的竞争也将从本体性能延伸到基础模型、开发接口和应用生态。
7 项具身推理评测领先,宇树进入开源模型前列
在 16 项多模态感知与理解基准测试中,宇树科技的 UnifoLM-ER-1(基于 Qwen3-VL-4B 构建)在 7 项上取得开源模型最佳成绩,整体性能可与头部闭源模型比肩。
从表中结果看,UnifoLM-ER-1 的优势主要集中在空间理解与推理。在 RefSpatial-Bench、Where2Place、PixMo-Point、BLINK、EmbSpatial、RoboSpatial 和 VSR 等 7 项基准中,它领先表中参评的开源模型;部分指标也高于 Gemini-ER 2 等闭源模型。
这些结果表明,UnifoLM-ER-1 在空间理解与推理方面达到开源模型前列。该能力决定机器人能否识别目标、理解空间关系,并为后续动作生成提供依据。
这 7 项结果的意义不在于机器人的运动性能,而在于模型对物体、空间关系和交互条件的理解。运动控制决定机器人能否稳定执行动作,具身推理则为机器人判断目标位置、规划交互过程和生成后续动作提供基础。
这组结果覆盖物体指代、摆放位置、视觉指向和空间关系等多个维度,反映了模型较为完整的空间感知与推理能力。开放模型与评测结果也为后续复现和比较提供了基础。
从这组基准结果看,宇树的具身推理模型已进入开源模型前列。
一个模型覆盖 64 项任务:从桌面操作到全身操作
UnifoLM-WLA-1.0 覆盖 64 项任务,包括 10 项全身操作和 54 项桌面操作。
这 64 项任务的重点不只是数量,而是由同一个模型覆盖桌面操作和全身操作,并协调机械臂、末端执行器与下肢动作。
过去的人形机器人系统常针对不同任务训练或配置不同策略,开发和迁移成本较高。UnifoLM-WLA-1.0 使用一个 6B 参数模型覆盖 64 项任务,并支持二指夹爪和多种五指灵巧手。
这表明同一模型能够覆盖多类任务,并适配多种已纳入训练和测试的末端执行器。在整理鞋子、厨房或浴室等全身任务中,机器人需要一边移动,一边连续操作;铺床时,双臂动作也要与身体姿态和下肢平衡协同。
UnifoLM-WLA-1.0 中的 WLA 是 World-Language-Action,即世界-语言-动作。模型把具身推理、未来动态区域预测和动作生成纳入统一框架,使机器人先理解当前环境和可能发生的变化,再生成动作。
这种统一模型有望减少为每项任务分别开发策略的重复工作,并提高模型在相近任务和已支持硬件之间的复用效率。与单项演示相比,64 项任务展示的是同一模型覆盖多种操作的能力;其跨场景与跨本体泛化仍需通过更多真实环境测试验证。
逐步开放模型与数据,争夺开发者生态
目前,宇树已上线 UnifoLM-WLA-1.0 项目主页,并开放部分模型权重和数据。后训练代码、UnifoLM-WLA-Base 权重、全身遥操作数据集和操作数据集仍列在后续开放计划中。
模型开放之后,开发接口和硬件适配将影响其应用范围。具身模型需要与不同机器人本体、传感器和控制系统连接;被更多开发者和硬件平台采用的模型,更有可能形成广泛使用的接口规范。
宇树既开发机器人本体,也训练基础模型。开放模型可以降低开发者的试用和二次开发成本,吸引更多团队适配其模型接口,并借助外部测试与反馈加快迭代。这些积累可能扩大其模型和接口在行业中的影响力。
短期内,开放的权重和数据可以减少中小型机器人公司与研究机构从零训练基础模型的成本,使其更快开展特定场景的适配与验证。实际部署仍需要结合本体、数据和控制系统进行工程开发。
长期来看,具身基础模型的竞争可能进一步加剧。部分公司将提供可适配多种本体的基础模型和开发平台,另一些公司则专注于机器人硬件、行业数据和场景集成;两类能力也可能在同一家公司内协同发展。
接下来需要观察的是,已开放模型能否在更多真实环境中保持任务成功率和泛化能力,以及开发者能否围绕模型形成持续的复现、适配与应用。(红星新闻网)
来源:互联网
声明:此文版权归原作者所有,若有来源错误或者侵犯您的合法权益,您可通过邮箱与我们取得联系,我们将及时进行处理。邮箱地址:zhaobozhi@jnexpert.com
- 人工智能
- 机器人
- 大模型
- 生成式AI
推荐
 34751
 20488
 19109
 24493
 21205
 16190
相关文章

我要评论