
从快手业务实践到全球开源共建,Apache Auron 毕业成为 Apache 顶级项目
-
2小时前
来源:极客公园
当下,数据规模持续增长与算力成本压力并行,大数据计算引擎的性能优化走向执行引擎级的重构,向量化执行与原生执行成为突破性能瓶颈的重要方向。
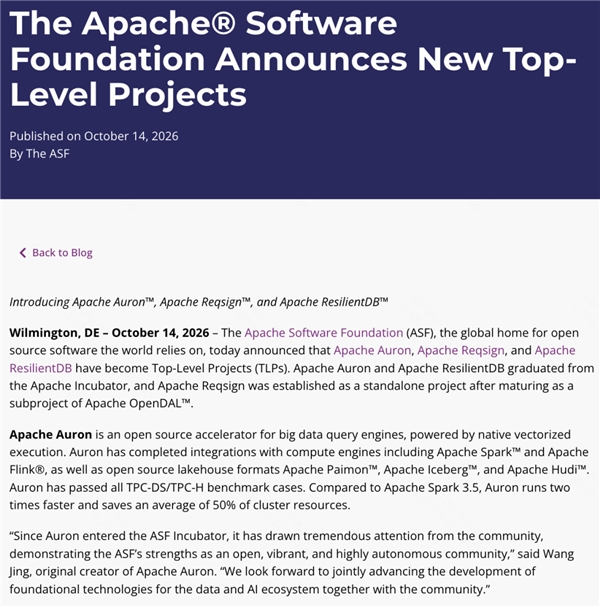
10 月 14 日,国际权威开源软件基金会 Apache 官方博客正式发布 Apache Auron™ 毕业消息,宣布 Apache Auron 从孵化器毕业,成为 Apache 顶级项目(Top-Level Project,TLP)。此前,Apache Auron 的毕业提案已于 2026 年 9 月在 Apache 孵化器项目管理委员会(IPMC)投票中顺利通过,并随后获得 Apache 软件基金会董事会批准。至此,Auron 正式从孵化阶段走向独立自治,进入 Apache 顶级项目治理体系。
作为源于快手大规模数据计算的生产实践,Auron 由快手公司立项、研发,于 2025 年 8 月捐赠给 Apache 软件基金会孵化器。从进入孵化器到顺利毕业,Auron 仅用时 13 个月。
Apache Auron 是一个面向大数据引擎的原生向量化执行加速器,当前聚焦于加速 Apache Spark 的查询处理。它结合 Apache Arrow-Data Fusion 的原生计算能力与 Spark 的分布式计算框架,将 Spark 优化后的物理计划转换为等价的原生执行计划,交由基于 Rust 实现的 Native Engine 执行,在提升性能的同时降低资源开销。目前,Auron 已在数十家企业的生产环境中完成部署,覆盖多个行业的业务场景,并在实际线上运行中取得显著的降本增效收益。
快手高级副总裁、研发线负责人郭亮表示,Auron 项目在快手公司立项、研发,并取得了大规模的落地实践和非常可观的大数据成本优化收益,快手一直秉承开放、共创的技术开源精神,并将 Auron 捐赠给 ASF,也期待能与社区一起推动 Data + AI 生态基建技术发展。
突破向量化执行技术,让大数据计算引擎跑出「原生」速度
从一项团队内部的技术探索,到由全球开发者共同建设的开源项目,Auron 的起点源于快手日常生产中大规模数据处理的真实挑战。随着数据规模持续增长,基于 JVM 的行式处理逐渐成为 Spark 的 CPU 性能瓶颈。快手给出的解法,是不改动上层业务 SQL,而为 Spark 替换一层更高效的执行引擎。
在项目孵化期间,Auron 社区保持高速迭代与稳定发布,累计发布三个版本;过去 6 个月,master 分支共合入 179 个 commit,贡献者来自 20 多家不同公司。毕业之际,社区已有 18 位 Committer 依毕业决议全部转为项目管理委员会(PMC)成员,并与 4 位孵化导师共同组成 22 人的 PMC,形成了多元化、跨组织的治理格局。
正是由于汇聚了不同开源项目、拥有丰富 Apache 社区经验的 PPMC 成员与 Committer 的团队,Auron 顺利突破技术瓶颈,为大数据计算领域贡献了重要发展成果。此前,传统大数据计算引擎采用逐条处理的方式:每处理一条数据,都要完整走一遍固定流程,数据量越大,CPU 延迟就越明显。为突破这一瓶颈,Auron 采用向量化执行按批(Batch)处理数据,从而最大限度发挥 SIMD 指令优势,充分利用 CPU 的并行计算能力。
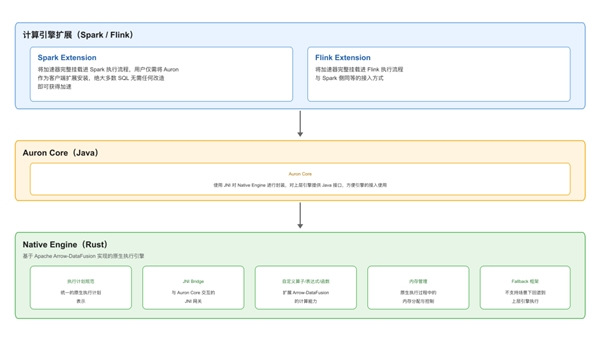
从具体技术路径来看,Auron 的核心架构主要分为四大部分:Spark Extension,能实现将加速器完整挂载进 Spark 执行流程,用户仅需将 Auron 作为客户端扩展安装,绝大多数 SQL 无需任何改造即可获得加速;Flink Extension,支持加速器完整挂载进 Flink 执行流程;Auron Core,使用 JNI 对 Native Engine 进行封装,对上层引擎提供 Java 接口,方便接入使用;Native Engine(Rust),以基于 Apache Arrow-Data Fusion 实现的原生执行引擎,提供包含执行计划规范、JNI 网关、自定义算子/表达式/函数,以及内存管理、Fallback 框架等基础能力。
基于此,Auron 在多维度上呈现出优秀的加速性能。原生执行、性能可预期,核心引擎由 Rust 实现,规避 JVM 开销,具备稳定、确定性的执行性能;向量化计算基于 Apache Arrow 列式格式,利用 SIMD 指令批量处理数据,最大化计算吞吐;完善的 Fallback 机制使未实现的算子和表达式可自动回退到 Spark 原生执行,UDF/UDTF、UDAF 等自定义函数同样支持,保证「只要 Spark 能跑,Auron 就能跑」;可插拔架构面向多引擎扩展,当前深度集成 Apache Spark,并基于 Data Fusion 良好的可扩展性,扩展支持 Apache Flink 等其他大数据计算引擎。
在周边生态与生产夯实方面,Auron 适配开源湖仓格式 Apache Paimon™、Apache Iceberg™ 和 Apache Hudi,开源 Shuffle Service 框架 Apache Celeborn™ 和 Apache Uniffle,以及 HDFS、S3 等存储系统;同时具备多级内存管理、紧凑化 Shuffle 格式、自适应执行策略。
ASF Member、Apache Auron 孵化导师,LinkedIn Principal Staff Software Engineer 秦江杰表示,良好的版本兼容性和易用性一直是 Auron 非常突出的特点,也让 Native Execution 的性能收益能够更容易地落地到实际生产环境。
实现规模化落地验证,计算运行提速 2 倍+、节省约 50% 资源
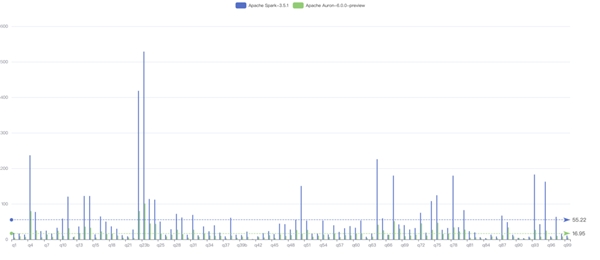
技术能力的价值,最终需要可量化的实际应用运行结果来检验。当前,Apache Auron 已全部通过 TPC-DS/TPC-H 基准用例;相比 Apache Spark3.5,在 TPC-DS 基准下 Auron 运行速度提升 2 倍以上,同时节省约 50% 的计算资源。在大规模生产环境中,Auron 已在超过 EB 级(Exabytes)数据规模下验证运行,覆盖 JSON 解析、UDF/UDTF 等复杂生产场景,并解决了多项稳定性与数据一致性问题。
除标准基准测试外,真实生产环境中的规模化部署情况,同样是衡量项目成熟度的重要依据。目前,Auron 已在快手、滴滴、58 同城、携程、OPPO、LinkedIn、汽车之家等数十家公司的生产环境中部署落地,并在线上场景中取得了显著的降本增效收益。
58 同城数据架构部负责人余意介绍,58 同城在大数据计算场景中持续关注并实践 Auron,已经落地任务 2.5W+,提效占比 65%,平均提效 45% 以上;Auron 通过原生向量化执行,在保持较低接入门槛的前提下,为现有大数据平台带来了更高的计算效率和更好的资源利用率。
滴滴大数据计算引擎负责人张润林表示,在大规模数据处理场景中,计算效率、运行稳定性与资源成本始终是关注的核心问题;Auron 以原生向量化执行技术为大数据计算加速,为企业提升计算效率、释放存量资源价值提供了新的选择。
从孵化走向毕业,Apache Auron 也将进入更广阔的生态场景。Apache Auron PMC Chair 王磊表示,Auron 将不断拓展生态版图,一方面,持续适配并完善 Apache Spark 、Apache Flink 等主流大数据计算引擎,让更多引擎的查询负载都能获得原生执行的加速能力;另一方面,基于 cuDF 打造 Auron on GPU 能力,把向量化执行从 CPU 延伸到 GPU,让 Auron 适应 AI 与 GPU 算力时代对高性能数据计算的全新需求。
具体来看,Auron 将继续围绕四大方向深耕:拓展应用生态,完善 Auron 在 Apache Flink 流和批场景的支持,以及对 Lance/Vortex 等新型存储格式的适配;增加对异构硬件的支持,从 CPU 向量化计算扩展到对 GPU 和 FPGA 等异构硬件的支持,进一步提升大数据引擎算子性能;贴近生产场景,持续提升各类算子与函数的覆盖率,以及解决性能、稳定性、数据一致性问题;做大社区、做强生态,携手更多企业与开发者以 Committer/Contributor 身份加入,共建开放、多元、可持续的社区。
从快手内部的工程实践,到 Apache 软件基金会的顶级项目,Auron 在一年多的孵化周期内完成了身份转换。对快手而言,Auron 的毕业不只是一次开源成果的交付。作为项目的发起方,快手在大规模数据处理场景中积累的工程经验,正通过 Apache 社区这一开放平台向更广泛的开发者与企业开放。未来,快手将持续参与 Data + AI 生态共建,把在大规模数据处理等领域的实践经验与社区共享,与各界伙伴一道,推动数据智能行业技术的创新突破。
来源:互联网
声明:此文版权归原作者所有,若有来源错误或者侵犯您的合法权益,您可通过邮箱与我们取得联系,我们将及时进行处理。邮箱地址:zhaobozhi@jnexpert.com
- 人工智能
- 大数据
- 数字化
- VP
推荐
 35020
 20765
 19340
 24771
 21411
 16406
相关文章

我要评论