
BioStack获950万美元融资:把医院数据转化为医学AI训练与评测体系
-
1天前
来源:机器之心
10 月 22 日,医疗数据基础设施初创公司 BioStack 宣布完成 950 万美元种子轮融资。公司创始人 Sanat Mishra
曾在斯坦福、耶鲁、卡内基梅隆和马克斯·普朗克研究所工作;另一位创始人 Parth Patwa 曾任 AWS 的生成式人工智能科学家和 MIT 的研究员,发表过 40 多篇相关领域的的论文。
BioStack 瞄准的是医疗 AI 开发中一个不太显眼、却直接影响模型能力的环节:医院积累了大量真实临床数据,但这些数据分散在不同的系统和机构中,难以直接用于模型训练。
一名患者的临床信息可能分别存在于电子健康记录、检验系统、影像系统、处方记录和后续随访中。单独一份病历或一张影像只能反映部分情况;如果能够把检查、诊断、治疗过程与长期结局连接起来,研究者就更容易分析疾病如何发展、患者对不同干预有何反应,以及哪些因素与治疗结果相关。
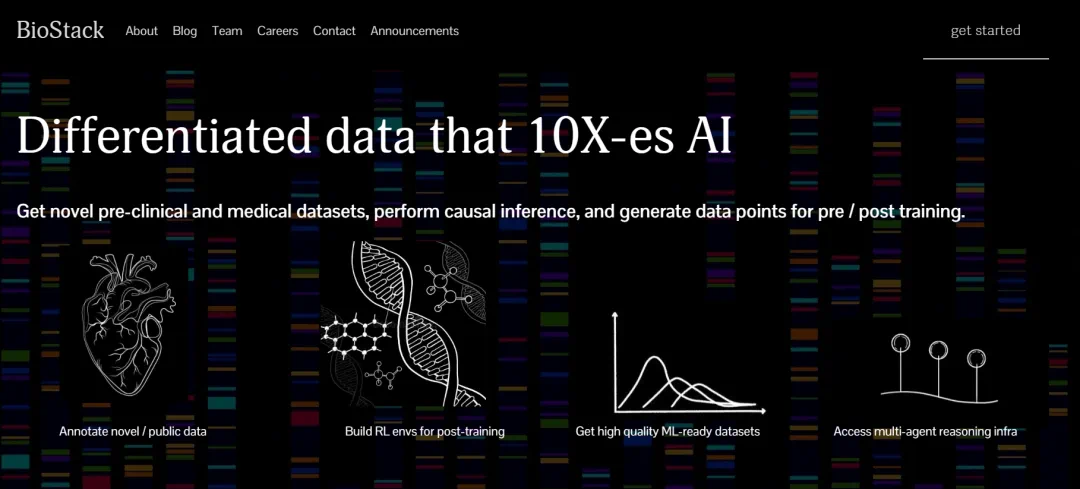
官网链接:https://www.getbiostack.com/
纵向、多模态数据
BioStack 的核心工作是将不同医疗系统中的临床信息组织成能够追踪患者病程的记录。其官网列出的数据类型包括电子健康记录、实验室检查、医学影像、心电图、临床笔记、音频、治疗信息和患者结局。公司会根据医疗机构的具体流程建立数据处理工作流,并对收集到的信息进行去标识化,再将其整理为面向研究与 AI 开发的数据集。
这一数据网络的覆盖范围,是此次融资消息中最受关注的数字之一。BioStack 称,其在美国、印度、巴西和阿根廷建立了医院合作网络,可接触超过 1 亿条去标识化患者记录。公司还表示,已将数十万量级的 X 光、MRI 和 CT 影像与病理及临床记录结合,并拥有数百万份远程医疗音频转录记录。
相关链接:https://www.prnewswire.com/news-releases/biostack-raises-9-5m-to-turn-global-hospital-data-into-multimodal-training-datasets-for-medical-ai-302916123.html
从官网展示的服务来看,BioStack 的业务不只涉及数据收集,还包括构建机器学习可用的数据集、标注新数据或公开数据、生成模型预训练与后训练数据,以及提供强化学习环境和多智能体推理基础设施。
影像基准
在 BioStack 发布的一篇技术博客「We Made Medical Al Show Its Work (Part 1)」中,BioStack 介绍了一套名为 Evidence-Grounded Multimodal Medical-Imaging Benchmark 的医学影像评测基准,共包含 513 道选择题,来自 135 个病例。
这套基准的初始数据来自公司自有的 186 例去标识化 CT、MRI 和 PET/CT 病例,每例配有放射科报告。整个数据集合计包含 134,828 个 DICOM 影像实例,分布在 2,166 个影像序列中。
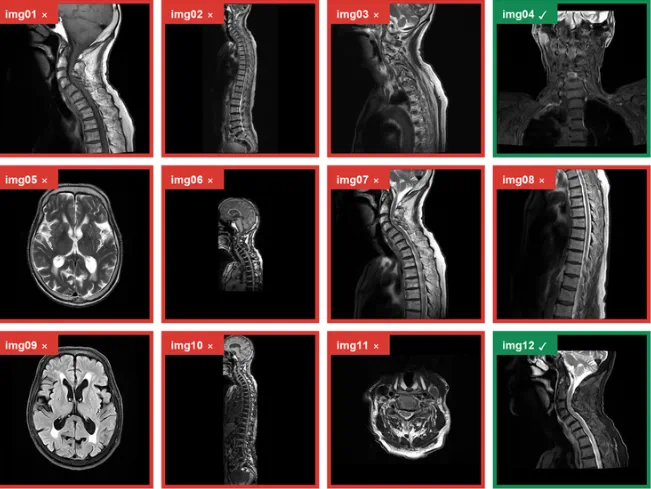
图示:用于说明的展示图像。
构建过程中,研究团队先根据放射科报告确定要评估的影像发现,再从完整影像序列中筛选可能显示该发现的切片,并将其与同一病例中的对照影像组合。最终,每道题都向模型提供 1 个问题、5 个候选答案,以及 7 至 12 张带有编号的影像。模型必须选择一个答案,并指出 1~3 张能够支持该答案的影像。
这套设计同时计算三类指标:
答案准确率,衡量模型是否选中了参考答案;证据准确率,衡量模型是否找到了可接受的支持影像;联合准确率,则要求答案和影像证据在同一道题上同时正确。只有当答案与证据通过时,联合准确率才会通过。
答案正确与过程正确
测试中,团队采用的是一套简短、固定的提示。
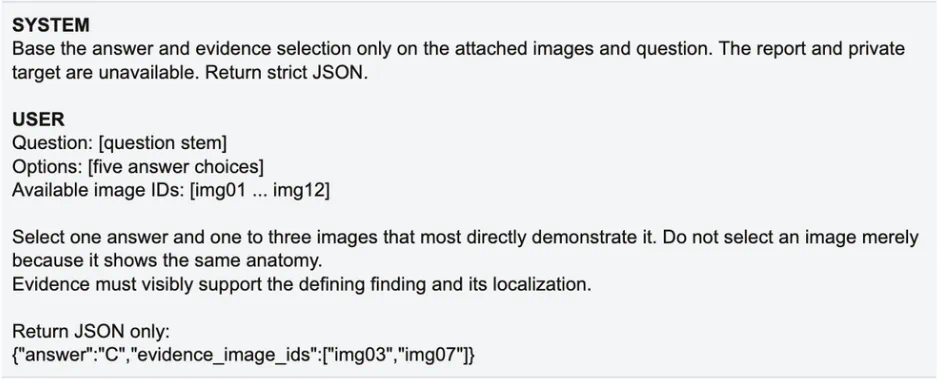
图示:团队所使用的提示词。
BioStack 在五次完整的前沿模型评测中报告,参与测试的模型答案准确率介于 33.9% 至 41.9%,但联合准确率只有 11.7% 至 25.0%。也就是说,在这套基准下,即使模型选出了正确答案,它也经常无法同时提供合格的影像证据。
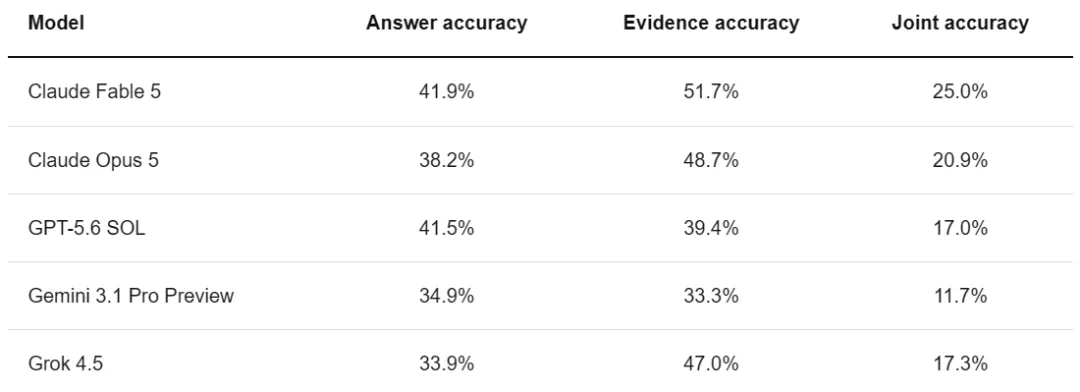
图示:评测结果。
每个模型在某些特定的案例中都会有专业的表现,但在基准测试中,却算不得发挥良好。最终数据集由 533 道候选题筛选而来。研究团队删除了 20 道需要精确测量值、但影像没有可用物理尺度的题目,留下 513 道。其中 329 道用于开发集、96 道用于验证集、88 道用于测试集,各集合按病例隔离。
可用的数据与可验证的能力
BioStack 此次获得的 950 万美元种子轮融资,将支持它继续扩展数据网络与技术平台。结合公司官网和这篇技术博客,其产品方向可以理解为两层:底层是把医疗机构的异构记录整理成可用于研究和模型开发的数据产品;上层则是为医疗 AI 建立数据标注、评测和后训练基础设施。
公司现有博客主要展示了一套基准的设计方法和模型评测结果,并没有证明使用 BioStack 的数据进行后训练后,模型性能已经得到改善。
因此,BioStack 的潜在竞争力不能只用记录数量衡量,还需要看其数据能否稳定地转化为高质量、可追溯且适合特定任务的样本,以及这些样本能否真正帮助客户改善模型。
声明:此文版权归原作者所有,若有来源错误或者侵犯您的合法权益,您可通过邮箱与我们取得联系,我们将及时进行处理。邮箱地址:zhaobozhi@jnexpert.com
- 生成式AI
推荐
 35140
 20929
 19451
 24915
 21506
 16511

我要评论