
NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%
-
2天前
来源:机器之心
在 LLM RL 训练里,生成正在变成最耗时的环节。当模型输出越来越长,训练阶段面对的是算力约束,增加训练卡数可以有效缓解算力压力,但推理部分是受限于显存带宽,往单个推理实例上继续堆卡,很快就会撞上扩展性的天花板。在训推混合的框架上,继续堆算力只会造成更多的算力资源浪费。
深圳市大数据研究院团队与华为联合研发的 ASP(Adaptive Scheduling Pipeline),实现面向多实例异步 RL 训练的自适应调度流水线。它做的第一件事是把生成和训练解耦,但真正关键的是第二件事:用一套队列感知的调度策略,一次性消除多实例 rollout 里的三类气泡:padding 气泡、skewness 气泡和 sorting 气泡,减少算力资源的浪费,提高 RL 训练性能。
值得一提的是,ASP 完全基于国产昇腾算力构建与验证,采用昇腾 910B3 NPU 与 MindSpeed-RL 生态。据公开信息检索,这是首个被 NeurIPS 接收的、基于国产昇腾算力的大模型 RL 训练加速系统工作,同时也是昇腾框架层首个登上 A 类顶会的成果。作为国产 AI 芯片的龙头企业,昇腾生态由此证明了它完全有能力做出国际前沿的研究工作,并赢得 AI 领域广大学者的认可 —— 在当前大模型训练基础设施高度依赖海外算力且存在国际制裁的大背景下,这具有重要的标志性意义。NeurIPS 的接收意味着该工作经历了国际顶级学者严格的双盲同行评议,在原创性、严谨性与实验可复现性上经受住了层层检验。曾立博士在 cncc 2026 论坛上也将此论文成果进行了报告分享,引起了学界和业界的广泛关注。
结果上,ASP 的生成吞吐最高提升 222%,单轮迭代时间最多降低 76%。在扩展性表现上,卡数增加后迭代时间变化接近线性,在约 3.3 个训练步的策略滞后下,依然没有明显的收敛退化。
这套系统已经在电信领域的真实 RL 训练任务里跑起来了,在百卡昇腾集群上整体训练周期从 3 个月以上压缩到约 2 个月,产出的领域增强模型可直接投入业务使用。目前只基于 MindSpeed-RL,将来会迁移到 verl 框架并安排开源。
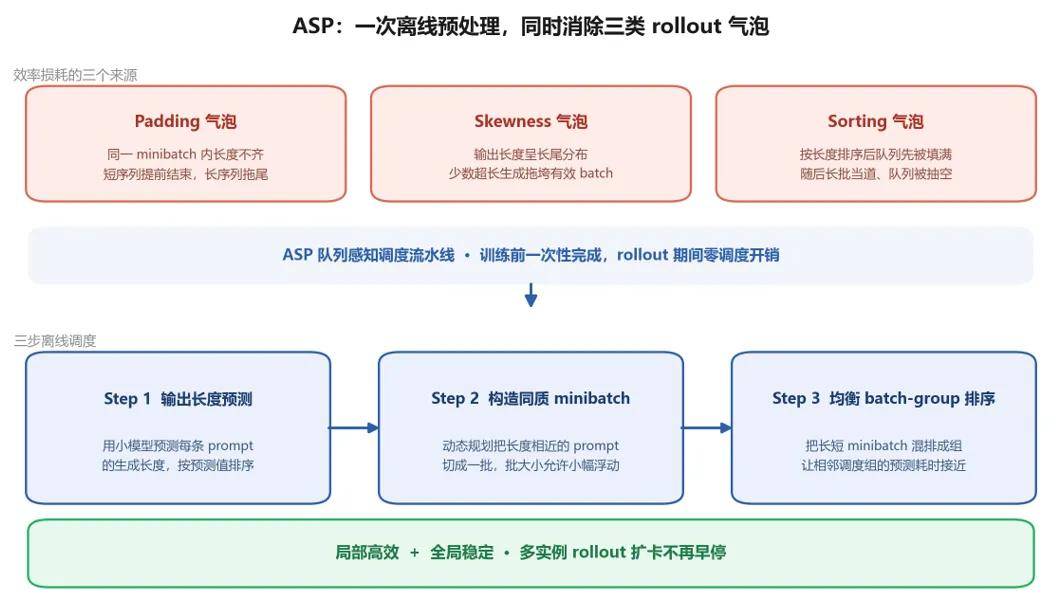
ASP 的整体思路。一次离线预处理,同时针对三类 rollout 气泡:先预测长度,再构造长度同质的 minibatch,最后把长短批混合编排成负载均衡的调度组。
论文地址:https://github.com/EntongL/ASP/blob/main/AdaptiveSchedulingPipelineforMultiInstanceAsynchronousReinforcementLearning.pdf
背景介绍:生成为什么成了瓶颈
RL 训练已经成为大模型能力提升的核心环节。它靠模型自己生成的回答和奖励信号来训练,换来更好的对齐与推理能力。
但每一次策略更新,都要走完一整套流程,rollout 生成、奖励打分、log-prob 计算、反向传播。随着输出越来越长,rollout 生成成为主导瓶颈,占据了训练总时间的很大一块。
目前最主流的做法是混合式循环。每一轮先做推理,再拿生成出来的样本跑一次训练。结构简单,样本也贴近当前策略,但缺点也很明显。
训练器在更新参数时,没有新样本在生成,卡处于闲置状态。推理和训练反复切换模式,同一批机器还要重新分片。更麻烦的是,这两个阶段的系统特性完全不同。反向传播是计算受限的,喜欢大规模同步并行;而推理生成是显存带宽受限的,往单个推理实例加资源,收益很快就到顶。
解耦只解决了一半
异步和训推分离的流水线,让 rollout 生成和训练可以同时进行,解决了上面一部分问题。但把生成和训练分开,并不会自动让多实例 rollout 生成变得高效和稳定。
当多个 actor 并行解码长度不一的回答时,系统要同时处理两个互相耦合的目标。一个是让每个推理 minibatch 内部保持高利用率,另一个是让全局的生产者 — 消费者关系(即 rollout 生成和训练)和 Training Queue 保持稳定。所以真正的问题不只是怎么把生成和训练分开,而是怎么调度 rollout,让异步生成既快又可控。
为了实现高效的调度,我们分析了在当前场景下 rollout 和训练过程中存在的气泡,并将识别出的气泡划分为以下三类:
1. Padding 气泡。同一个 minibatch 里的 prompt,生成的回答长度不一样。短的先结束,actor 却还被最长的那个占着,实际有用的 token 生成量,远小于按最长回答算出来的 padded 计算量。
2. Skewness 气泡。LLM 的输出长度是长尾分布,少数几个超长生成,会在解码后期把有效 batch 大小直接压塌。
3. Sorting 气泡。把 prompt 按预测长度排序,能缓解前两个问题,却引入了第三个。如果短的 minibatch 先派发、长的后派发,生成速率会随时间变化,Training Queue 先被快速填满,随后又慢慢抽空。我们把它叫做队列层面的不稳定。
问题就在这里。按长度排序对单个 minibatch 是好事,对整条流水线的时间稳定性却可能是有害的。为了解决以上三种气泡,我们提出了 ASP,通过离线预处理的方式,预测并调整样本的排序组合,减少气泡带来的资源浪费,提高整体训练性能。
方法概览:三步离线调度,同时消除三类气泡
ASP 的思路,是把调度从「负载均衡的算法细节」转变为异步 RL 里的可插拔组件。它用输出长度预测给 prompt 排序,用动态规划构造长度同质的推理 minibatch,再用均衡的 batch-group 排序把长短 minibatch 混在一起,让相邻调度组的预测处理时间接近。
整个调度是训练前一次性完成的离线预处理,只用预测长度,rollout 期间不增加任何在线调度开销,具体步骤如下:
Step 1,输出长度预测。先用目标模型跑一小部分 prompt,收集 prompt 与长度的对应关系,微调一个与目标模型同系列但参数量更少的小模型(我们使用了 Qwen2.5-1.5B)来做长度预测,按预测值排序。这里的预测器不需要预测精确长度,只要给出有用的相对排序就够了。调度器真正依赖的是排序,而不是绝对值。
Step 2,构造长度同质的 minibatch。固定批大小在排序列表里遇到大间隔时依然会浪费。ASP 允许批大小在基准值附近小幅浮动,用动态规划找到让平均利用率最高的那种划分,最大程度地减少 padding 气泡。
Step 3,均衡 batch-group 排序。最后一步把 minibatch 重新排成组,让每组的总预测负载大致相等。这样不再是「先发所有短批、后发所有长批」,而是长短交错,连续调度组的预测耗时接近,sorting 气泡随之消失。
把调度接进有滞后版本控制的异步系统
调度只是一半。ASP 把整个系统拆成三个部分。Training Unit(TU)负责奖励计算、log-prob 评估和策略更新;一个或多个 Generation Unit(GU)各自承载多个生成 actor;一个同址部署的 Control Unit(CU)负责派发调度好的 minibatch,并通过受控的 Training Queue 把完成的样本转给 TU。
Training Queue 是稳定性的关键。它吸收生成时间的短期波动,同时把队列占用情况暴露给 CU,调节 CU 派发样本的速度:样本到得比 TU 消耗得快,派发就被节流;队列见底,CU 就继续把生成 actor 喂饱,生产更多的样本。
异步 rollout 还会带来第二个问题,样本可能来自比当前训练权重稍旧的模型。ASP 通过限制可滞后的权重版本数量来处理。TU 完成训练步后定期导出权重快照,转换成本推理可用的格式,actor 再异步加载;如果某个 actor 正在解码,它会先解完当前 minibatch 再加载,避免所有生成 worker 全局暂停。
这样既保住了解耦的核心好处,生成不中断,又把策略滞后控制在可观测、有明确界限的范围内。
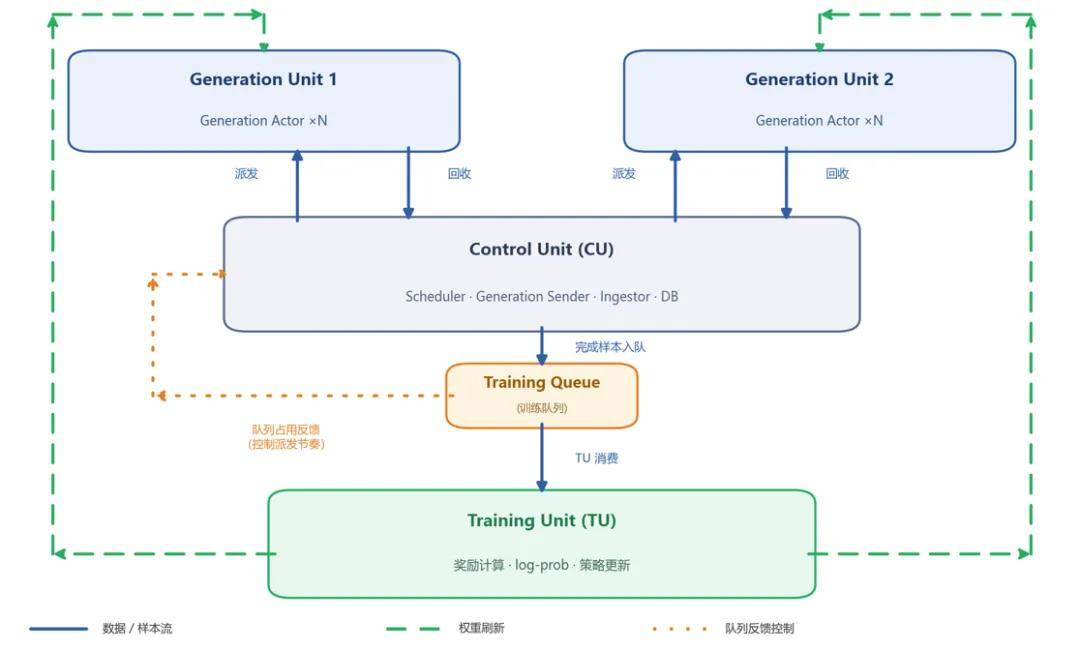
ASP 系统架构。蓝色实线为数据 / 样本流:CU 将调度好的 minibatch 派发到各 GU,actor 生成后回传完成样本,经 CU 传入 Training Queue,再由 TU 消费;绿色虚线为权重刷新路径(Latest Weights,各 GU 异步加载);橙色点线为队列占用反馈(控制派发节奏)。
实验结果
ASP 基于 MindSpeed-RL 实现,采用 GRPO,在昇腾 910B3 上进行 RL 训练,一共使用了 8 个节点,每个节点有 8 张 NPU,共 64 个 NPU。评测模型是 MoE 的 Qwen3-30B-A3B 和稠密的 Qwen3-32B,对比对象是同一生态下的混合式基线 MindSpeed-RL,以及异步解耦基线 verl。
端到端性能
在 Qwen3-30B-A3B 上,ASP 的迭代时间是 216s,对比 MindSpeed-RL 的 927s,降低了 76.7%;对比 verl 的 536.7s,降低了 59.9%。
在 Qwen3-32B 上,ASP 的迭代时间是 230.7s,对比 MindSpeed-RL 的 928s,降低了 75.1%;对比 verl 的 615.1s,降低了 62.5%。
吞吐上的提升同样明显。Qwen3-30B-A3B 上 ASP 达到 58 tokens/s/NPU,混合式基线是 18,verl 是 44,对应约 3.22 倍和 1.31 倍的提升。
MoE 和稠密模型上一致的收益说明,改进来自系统设计本身,也就是「解耦的多实例 rollout 加队列感知调度」,而不是某个模型特有的偶然结果。
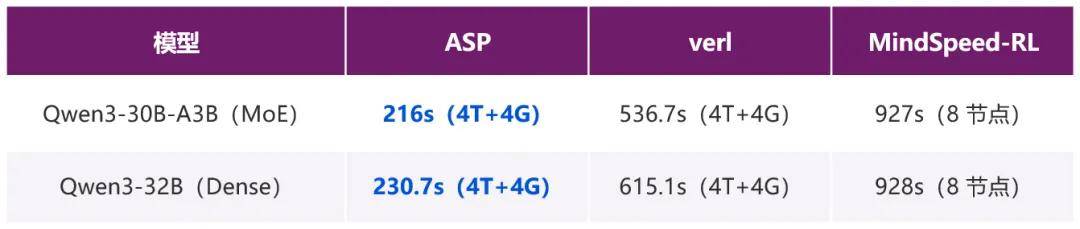
表 1 端到端迭代时间(论文原表 3)。括号内为节点配置,T 表示训练节点,G 表示生成节点。
调度消融
把调度策略单独拆出来看,ASP 平均降低迭代时间 11%。这里最值得说的不是 padding 上的节省。通过均衡相邻 batch-group 的预测负载,ASP 还平滑了 minibatch 的完成时刻,减少了队列振荡。这在异步场景里很重要,因为同步的完成突发会压垮 CU/TU 通路,触发不稳定的队列行为;而更平滑的到达过程,能让流水线更贴近它自己的平衡工作点。
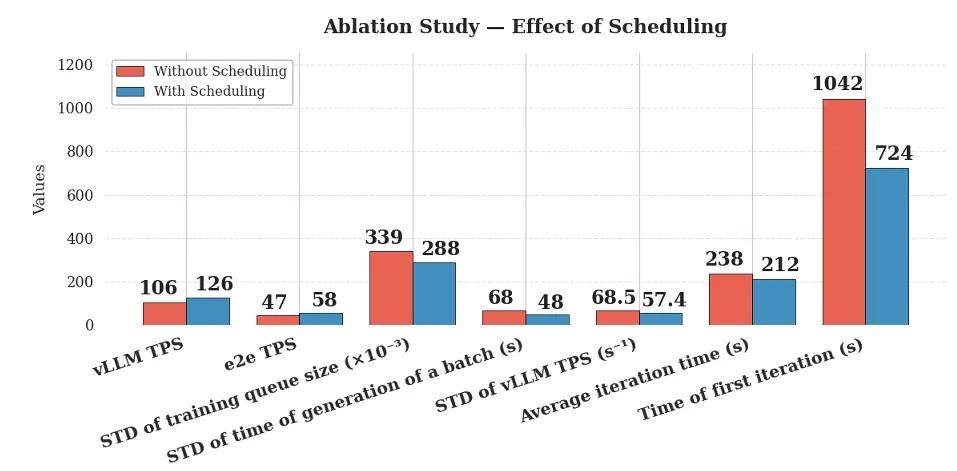
调度消融(Qwen3-30B-A3B)。开启调度后,队列相关指标的波动明显收敛,平均迭代时间下降 11%。
可扩展性
随着 NPU 数量增加,解耦框架的优势会越来越明显,因为 rollout 会随资源增加而加速。如下图所示,ASP 在每个测试规模上都拿到更低的迭代时间,而且生成资源越多,差距越大。从 1 个 GU 节点扩到 3 个、4 个 GU 节点,迭代时间从 776s 降到 288s、216s,对应 2.69 倍和 3.59 倍加速,接近理想线性。这正是多实例 rollout 的价值所在。单实例推理会早早进入扩展平台期,而多实例加队列感知调度,让加卡这件事重新变得线性。
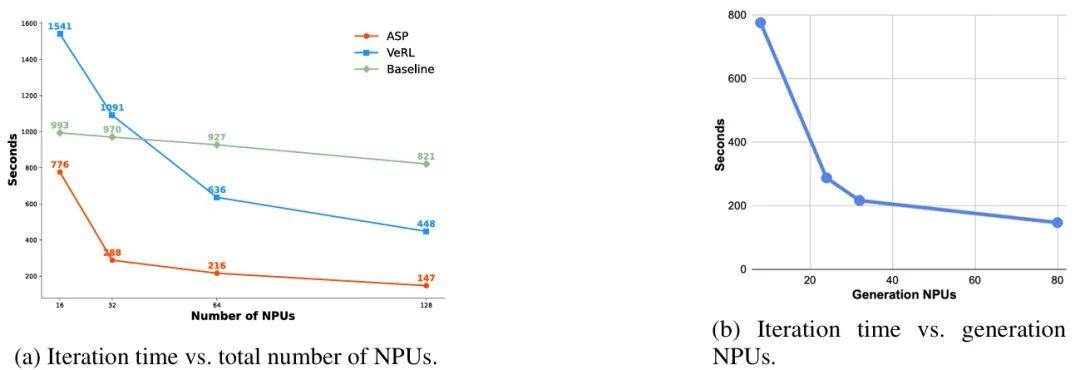
可扩展性(Qwen3-30B-A3B)。左图为迭代时间随总 NPU 数变化,右图为随生成 NPU 数变化。ASP 在每个规模上都保持更低耗时,直到瓶颈转移到训练侧。
有滞后版本限制下的收敛
异步执行会不会伤到学习,这是所有异步方案都要回答的问题。在 1 个 TU 节点加 3 个 GU 节点的配置下,实测的有效 off-policy 距离约为 3.3 个训练步。跑 30 轮 GRPO,ASP 与混合式基线到达相近的 maze integrity 平台,ASP 因为纯生成预热有短暂的初期延迟;maze correctness 也是同样的结论。
实测在有限制的滞后下,没有可见的收敛退化。队列感知调度、有界队列和延迟权重刷新,把异步流水线稳定在一个小滞后的工作区间里,同时把吞吐收益拿到手。
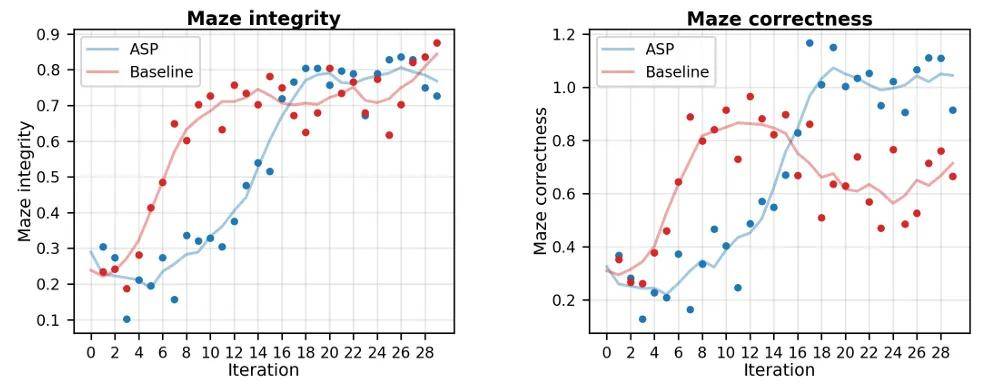
收敛性(MAZE-REASONING-GRPO-V0.1)。在约 3.3 个训练步的滞后下,ASP 与混合式基线到达相近的平台,未出现可见退化。
产业落地
除了论文中的实验,ASP 已经在基于百卡甚至千卡昇腾集群的电信场景真实落地,模型为 Qwen3-235B-A30B。在该部署中,整体训练周期从 3 个多月缩短到约 2 个月,训练出的领域增强模型已用于知识问答、工具调用等电信业务。由于流程、数据和部署细节保密,论文只把它作为实用性的定性证据,没有纳入受控实验对比。
这套能力的意义不单单在于提高 RL 训练的效率。电信是重资产、强专业场景,模型需要持续吸收海量工单、运维知识与客服话术等专业数据,而传统训练周期都是以月为单位,模型往往跟不上业务的快速迭代。ASP 把训练周期大幅压缩,让「更快用上更懂业务的模型」成为现实。同样的思路还可迁移到政务、电力、金融、制造等高专业度行业,使国产算力上的大模型后训练从「训得动」走向「训得快、用得起」,为运营商等行业的大模型规模化落地提供可复用的基础设施。
总结与展望
ASP 想回答的问题其实很具体。在训练和推理解耦后,怎么让多实例异步 RL 跑得更好。生成需要在每个 actor 内部高效,在 Training Queue 上稳定。ASP 用一次离线的队列感知调度补上了这一层,预测长度、构造同质 minibatch、均衡分组排序。它带来的是一条更实用的路径,让异步多实例 RL 训练既快,又可控。对国产算力上的大模型训练来说,这意味着同样的卡能跑出更多的有效迭代。
目前的原型跑在昇腾 910B3 的 MindSpeed-RL 生态里,受限于资源,规模上限是 128 张 NPU。下一步,会在更大的集群、更强的策略漂移和课程学习场景里继续检验这套调度机制。
参考文献
[1] Adaptive Scheduling Pipeline for Multi-Instance Asynchronous Reinforcement Learning. Advances in Neural Information Processing Systems (NeurIPS), 2026.
作者介绍
Luis Henrique Zuin Ruiz:华为在职实习生,巴黎综合理工学院数学专业在读研究生,主要研究方向是数学建模与 AI 应用。
Salah Chikhi:巴黎综合理工学院数学专业在读研究生,主要研究方向是数学理论与深度学习的结合。
黎恩彤:深圳市大数据研究院工程师,主要研究方向是 AI infra 加速优化以及训练加速优化。
曾立:深圳市大数据研究院主任研究科学家,研究方向主要包括大模型训推加速、向量计算与知识搜索、图计算等。
声明:此文版权归原作者所有,若有来源错误或者侵犯您的合法权益,您可通过邮箱与我们取得联系,我们将及时进行处理。邮箱地址:zhaobozhi@jnexpert.com
- 生成式AI
推荐
 35244
 21053
 19552
 25034
 21603
 16601
相关文章

我要评论