
AMD 携手 CSDN 与 CTONE 在央视「进博新品汇」带来 AI 开发者一体机
-
15小时前
来源:极客公园
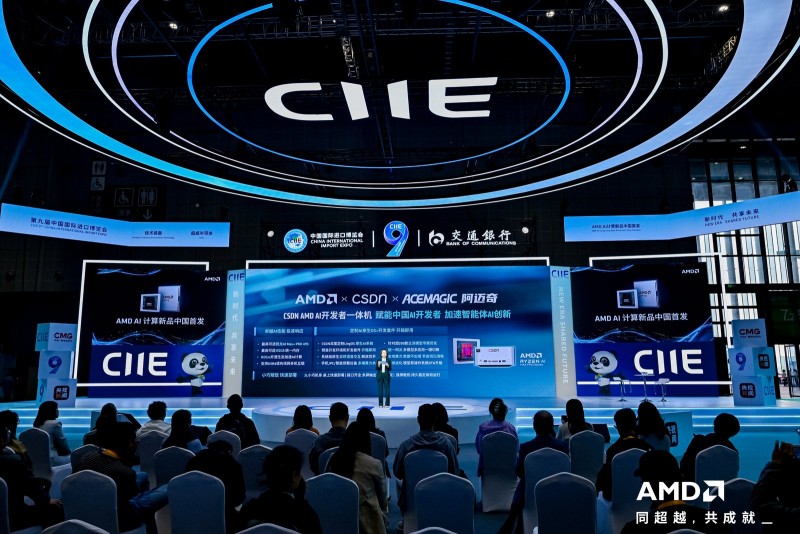
2026 年 11 月 6 日,在第九届中国国际进口博览会期间,AMD 携手领先的开发者社区 CSDN 与 AI 智算终端领军企业创通新科集团(CTONE),以创通新科旗下阿迈奇 F9A 智能体主机为算力底座,在央视新闻「进博新品汇」特别栏目亮相了搭载 AMD 锐龙 AI Max+ PRO 495 处理器的 AI 开发者一体机,为广大 AI 开发者带来集本地大模型、定制化 AI 开发环境、开放的 ROCm 软件栈支持和强大端侧算力于一体的 AI 开发赋能平台。
作为 AMD 本届进博会「赋能智能体 AI 时代」主题的又一落地成果,此次亮相的 AI 开发者一体机将高性能端侧 AI 算力与本土开发者生态相结合,给 AI 开发者带来开箱即用、部署简单、开放兼容、低开发成本的全新选项。AI 开发者一体机内置 AI OS 操作系统和智能体开发套件,并提供主流大模型的支持与统一管理,结合 AMD ROCm 开放软件生态,为开发者提供从模型部署、应用开发、测试验证到成果落地的一站式体验,降低 AI 开发与应用门槛,助力开发者实现基于本地大模型的 token 自由,推动本土人工智能开发者生态高质高速发展。
为 AI 智能体开发深度优化,以本地算力赋能开发者
随着生成式 AI 加速向智能体 AI 演进,AI 已经从简单的内容生成和问答,逐步走向任务规划、工具调用、多智能体协同以及跨应用执行。与单纯的模型推理相比,这类工作负载不仅需要 AI 加速能力,也更加需要 CPU 任务编排、GPU 并行计算、大容量内存以及软件生态的综合能力。
AMD 此次携手 CSDN 带来的 AI 开发者一体机针对开发者需求,将大模型、本地算力、AI 开发工具与熟悉的 PC 应用环境融于一体。开发者既可以直接将其作为独立 AI 终端使用,也可以作为本地 AI 算力中枢,面向代码智能体、本地知识库、内容生成、多智能体协同和行业 AI 应用等场景进行模型部署、开发和验证。
这一设计让开发者不必首先搭建复杂的云端开发环境,也无需投入大量时间配置本地模型和软件工具。预装和定制的系统、模型和开发环境可以进一步缩短从开机、模型调用到进入实际 AI 开发的时间,让开发者将更多精力用于 AI 智能体创意设计和应用开发本身。
AMD 锐龙 AI Max+ PRO 495,让 300B 参数级大模型在本地运行
AI 开发者一体机强大的端侧 AI 算力来自于 AMD 锐龙 AI Max+ PRO 495 处理器。作为 AMD 面向智能体主机推出的第二代平台,这款处理器将 CPU、GPU 和 NPU 三大算力引擎异构集成于一颗芯片中,让不同计算单元能够针对智能体 AI 工作流程中的不同任务协同工作,同时可以兼顾开发者日常生产力应用需求。
AMD 锐龙 AI Max+ PRO 495 处理器的 CPU 核心基于标准的 x86 架构,拥有 16 核 32 线程,最高加速频率可达 5.2GHz,原生兼容现有的 Windows 和 Linux X86-64 系统应用生态,减少转译和适配成本,能显著提升端侧智能体在任务编排和执行阶段的效率;而采用 AMD RDNA 3.5 架构的 AMD Radeon 8065S 显卡,拥有 40 个图形计算单元,能实现对多数主流开源模型的 Day0 快速适配支持;基于 AMD XDNA 2 架构的 NPU,可以低功耗地运行高频次实时 AI 进程,为持续运行的 AI 任务提供专用加速能力。
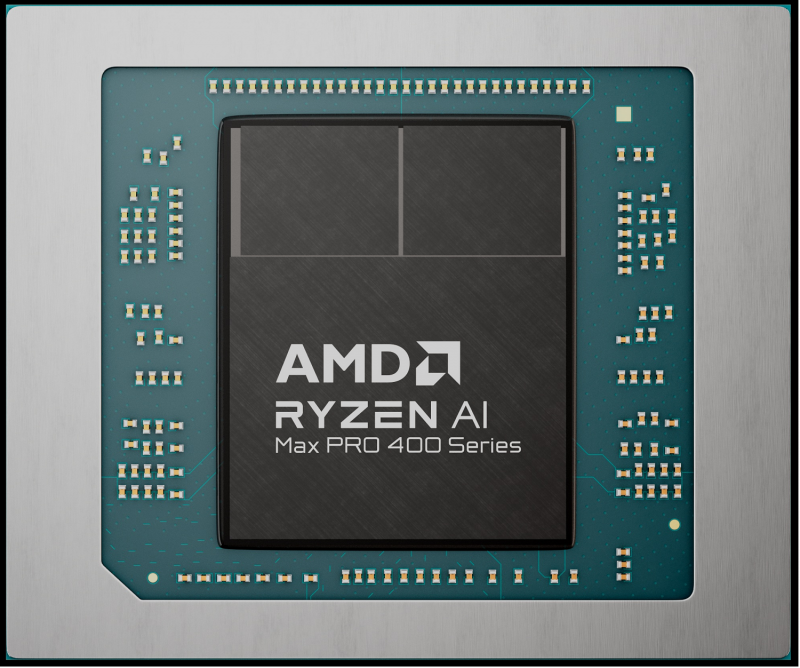
对于端侧大模型而言,要让模型装得下还能跑得快,除了强大的 AI 算力之外,内存容量更是关键。AMD 锐龙 AI Max+ PRO 495 采用统一内存设计,理论带宽高达 273GB/s 左右,内存容量相比上代产品进一步提升,最高支持 192GB LPDDR5x 统一内存,其中最高可有 160GB 分配给 GPU 作为显存使用,可以本地部署 3000 亿参数级大模型,为大型语言模型、长上下文和多智能体工作流的本地运行提供更大的内存空间。
而且,统一内存架构设计让 CPU、GPU 和 NPU 共享同一内存资源,无需像传统 CPU 加独立显卡架构一样受限于独立显存容量,也减少了模型数据在系统内存和独立显存之间频繁搬运带来的消耗。对于 AI 开发者而言,这意味着更多模型和工作数据能够留在本地内存中,为大参数模型推理、多个智能体同时运行以及复杂 AI 工作流提供更灵活和高效的资源池。
支持主流开源大模型,将「Token 自由」带给更多 AI 开发者
AI 应用开发正在越来越多地依赖大模型。代码生成、智能体调试、自动化测试、模型评估和应用验证通常需要大量且反复的模型调用。在以云端 API 为主的模式下,随着调用频率和上下文规模提升,Token 成本也随之增长,这可能成为高频 AI 开发和应用验证中需要考虑的重要成本因素。
现在,随着 AI 开发者一体机的推出,由其赋能的本地 AI 和大模型能力为开发者提供了全新的低成本选择。AI 开发者一体机通过将合适的 AI 推理负载部署到本地,让开发者可以利用自己拥有的本地算力反复调用本地模型、调试智能体和验证 AI 应用,无需为每一次本地模型推理额外支付云端 API Token 调用费用,在一定程度上实现「Token 自由」。
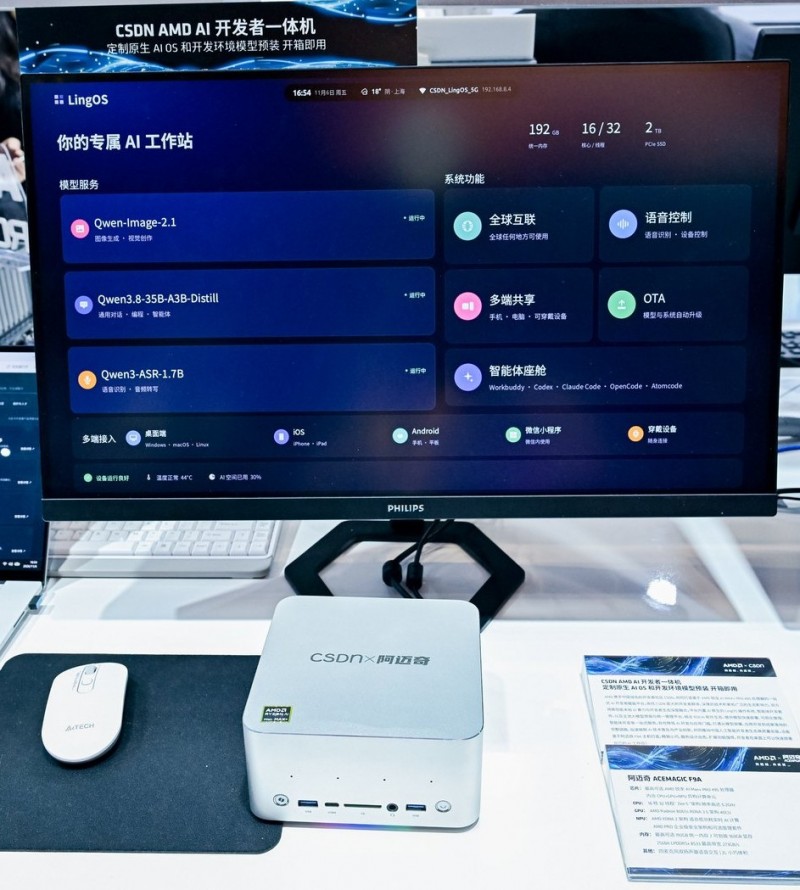
对于代码智能体而言,这一变化尤其具有实际价值。开发者可以持续进行代码生成、评估、测试和调试,让 Agent 执行更多轮任务并反复验证结果,而不用因为每一次本地模型调用都产生额外 Token 费用而限制实验频次。对于企业和行业开发者,将适合的 AI 工作负载放到端侧还能够减少敏感业务数据上传云端的需求,并在网络受限或无法稳定连接在线 AI 服务的场景中保持本地 AI 能力。
为了进一步降低本地 AI 开发门槛,此次亮相的开发者一体机还针对本土开发者的实际使用需求预置完整的软件和开发环境。基于 CSDN 开发者生态和对 AMD 锐龙 AI Max 平台的适配优化,开发者主机构建了 AI 原生 Ling OS,支持主流开源大模型,并通过统一网关对模型进行连接和调用。平台还支持 AI 算力在手机、电脑和可穿戴设备之间共享,并计划通过 OTA 持续升级模型和系统。开发者既可以直接将设备作为 AI 终端,也能够将其作为本地 AI 算力中心,为不同终端和应用提供模型能力。在 AI 开发之外,还能将其作为一台高性能的 PC 进行生产力或者设计创作使用。
从云端付费调用 Token 转变为拥有自己的「Token 工厂」,从复杂部署到贴近本土开发者深度定制的「开箱即用」和多设备无缝协作,AI 开发者一体机正在为 AI 创新提供一种更加自主、不设限、低成本的开发方式。
持续打造开放的生态,让更多 AI 创新在本地发生
AMD 正携手包括 CSDN 在内的生态伙伴,持续打造开源开放的开发者生态。AI 开发者一体机基于 x86 架构,原生支持 Windows 和 Linux 环境,以开放框架、开发工具以及经过验证的 AI 工作流降低配置和部署门槛。
AMD 推出了面向 AI 开发者的 ROCm.AI 原生开发体验,通过整合 ROCm CLI、AMD Skills 和 Hyperloom 等 AI 驱动的软件优化能力,将 AMD 的专业技术和最佳实践融入开发者熟悉的 AI 编程工具和工作流程,帮助开发者利用自然语言更便捷地安装、部署、调试和优化 AI 工作负载,从而降低 AMD 平台上的 AI 开发门槛,加快从创意到实际应用的开发进程。
而 CSDN 作为中国最大的开发者社区,拥有大量的软件开发资源积淀和 AI 开发用户。此次 AMD 携手 CSDN 将高性能端侧 AI 能力带给广大中国开发者,通过 AI 开发者一体机把大模型、本地 AI 算力和定制化的开发系统和工具放到开发者桌面,让开发者可以在自己掌控的环境中使用模型、处理数据、构建和验证智能体应用,并根据不同工作负载灵活选择本地或云端资源。
从「让大模型在端侧运行」,到「让开发者真正用端侧大模型进行开发」,AMD 正与包括 CSDN 在内的开发者生态伙伴一起,进一步降低智能体 AI 创新的门槛,让强大的本地 AI 算力成为更加普惠的开发基础设施,加速更多 AI 创意从构想、开发验证走向实际应用。
来源:互联网
声明:此文版权归原作者所有,若有来源错误或者侵犯您的合法权益,您可通过邮箱与我们取得联系,我们将及时进行处理。邮箱地址:zhaobozhi@jnexpert.com
- 人工智能
- 大模型
- 生成式AI
推荐
 35243
 21053
 19550
 25031
 21603
 16601
相关文章

我要评论