


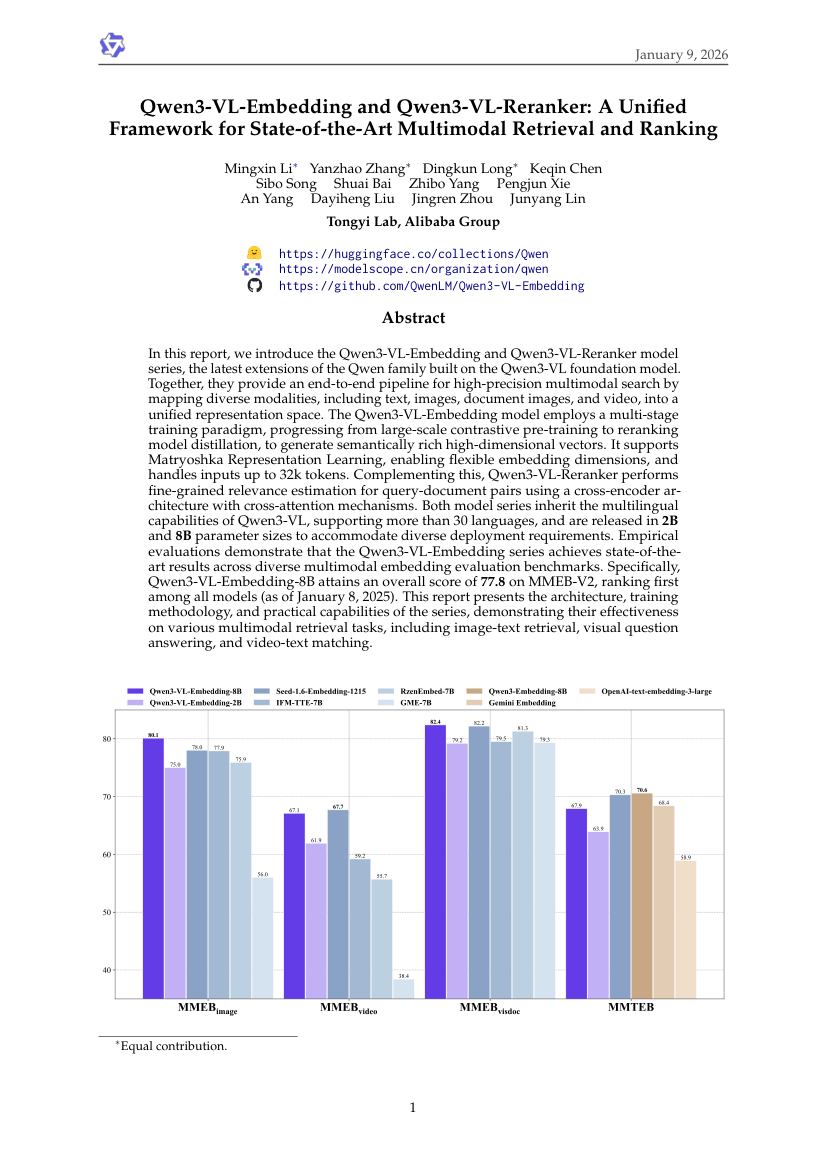
通义千问Qwen:2026 Qwen3-VL-Embedding与Qwen3-VL-Reranker技术报告(英文版)
23页۰2.47MB  2026-10-10
 金锦囊免费
|内容简介
本报告深入探讨了新一代多模态表征与重排序技术的架构创新与应用实践。针对复杂图文及视频检索中的语义鸿沟与细粒度匹配难题,报告详细解析了两大核心模型的技术突破。 在表征学习方面,模型引入原生多模态融合架构与动态分辨率视觉编码机制,结合跨模态对比学习与难样本挖掘策略,显著提升了长文本与高分辨率图像的联合向量表征能力,实现更精准的语义对齐。在重排序方面,采用基于深度交叉注意力与生成式架构的混合重排机制,有效攻克了多模态检索中的复杂逻辑推理与长尾语义匹配瓶颈,大幅提高排序精度。 此外,报告系统阐述了从大规模多模态预训练、指令微调到基于人类反馈强化学习的多阶段训练范式,并分享了算力优化与推理加速的工程经验。评测表明,相关模型在多模态检索、视觉问答等权威基准中均达到行业领先水平。最后,报告展示了其在多模态检索增强生成(RAG)、智能文档分析与视觉搜索等真实场景的落地成效,为构建下一代多模态AI应用提供了极具价值的技术参考。- 人工智能
- CTO
- 数字化
- 数字经济
- 大模型
- 生成式AI


最新报告

热门报告
报告信息
- 发布机构
- 发布时间
- 报告价格
立即下载