


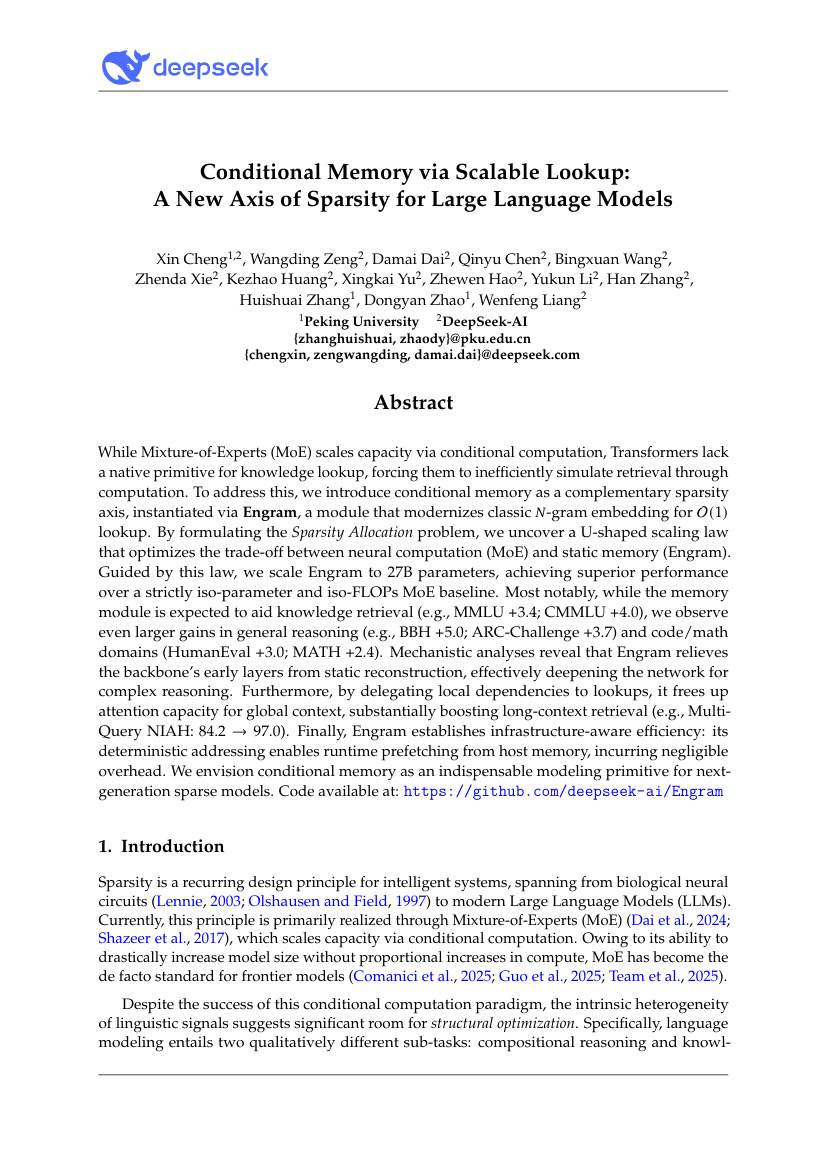
DeepSeek:2026基于可扩展查找的条件记忆:大型语言模型稀疏性的新维度技术报告(英文版)
33页۰824.98KB  2026-10-10
 金锦囊免费
|内容简介
本报告聚焦大型语言模型在处理长上下文与复杂推理时面临的计算及显存瓶颈,提出了一种突破性的架构创新。针对现有稀疏化技术在动态上下文管理上的局限,研究引入了一种结合可扩展查找算法的条件记忆机制。 该机制的核心在于将模型的稀疏性拓展至全新的“记忆状态”维度。通过设计高效的动态查找算法,模型能够根据当前输入条件,精准、按需地激活和检索特定的记忆块,而非全量加载或计算。这种条件触发的记忆管理方式,使得模型在维持庞大参数知识库和长程依赖能力的同时,实现了记忆读写与底层计算的高度稀疏化。 深度分析表明,该架构大幅降低了长文本处理中的显存峰值与推理延迟,并显著提升了模型在复杂逻辑推理和知识密集型任务中的表现。此研究打破了传统参数权重与注意力机制的稀疏边界,为下一代超大规模、超长上下文语言模型的低成本训练与高效部署提供了极具前瞻性的技术范式。- 人工智能
- 大模型
- 生成式AI
- CTO
- 数字化
- 大数据


最新报告

热门报告
报告信息
- 发布机构
- 发布时间
- 报告价格
立即下载